
 Set up docs MCP
在下面的示例中,我们使用 Kafka Connect 的 Confluent 发行版。
下面将介绍一种简单安装方式:从单个 Kafka topic 拉取消息,并将行插入 ClickHouse 表中。对于尚未搭建 Kafka 环境的用户,我们推荐 Confluent Cloud,它提供了相当宽裕的免费层级。
请注意,JDBC 连接器 需要 schema (您不能将纯 JSON 或 CSV 与 JDBC 连接器 一起使用) 。虽然也可以将 schema 编码在每条消息中,但强烈建议使用 Confluent Schema Registryy,以避免相关开销。提供的插入脚本会自动从消息中推断 schema 并将其插入 registry,因此该脚本也可复用于其他数据集。Kafka 的 key 默认假定为 String。有关 Kafka schema 的更多信息,请参见这里。
许可证
JDBC Connector 按照 Confluent Community License 发布
步骤
准备连接详细信息
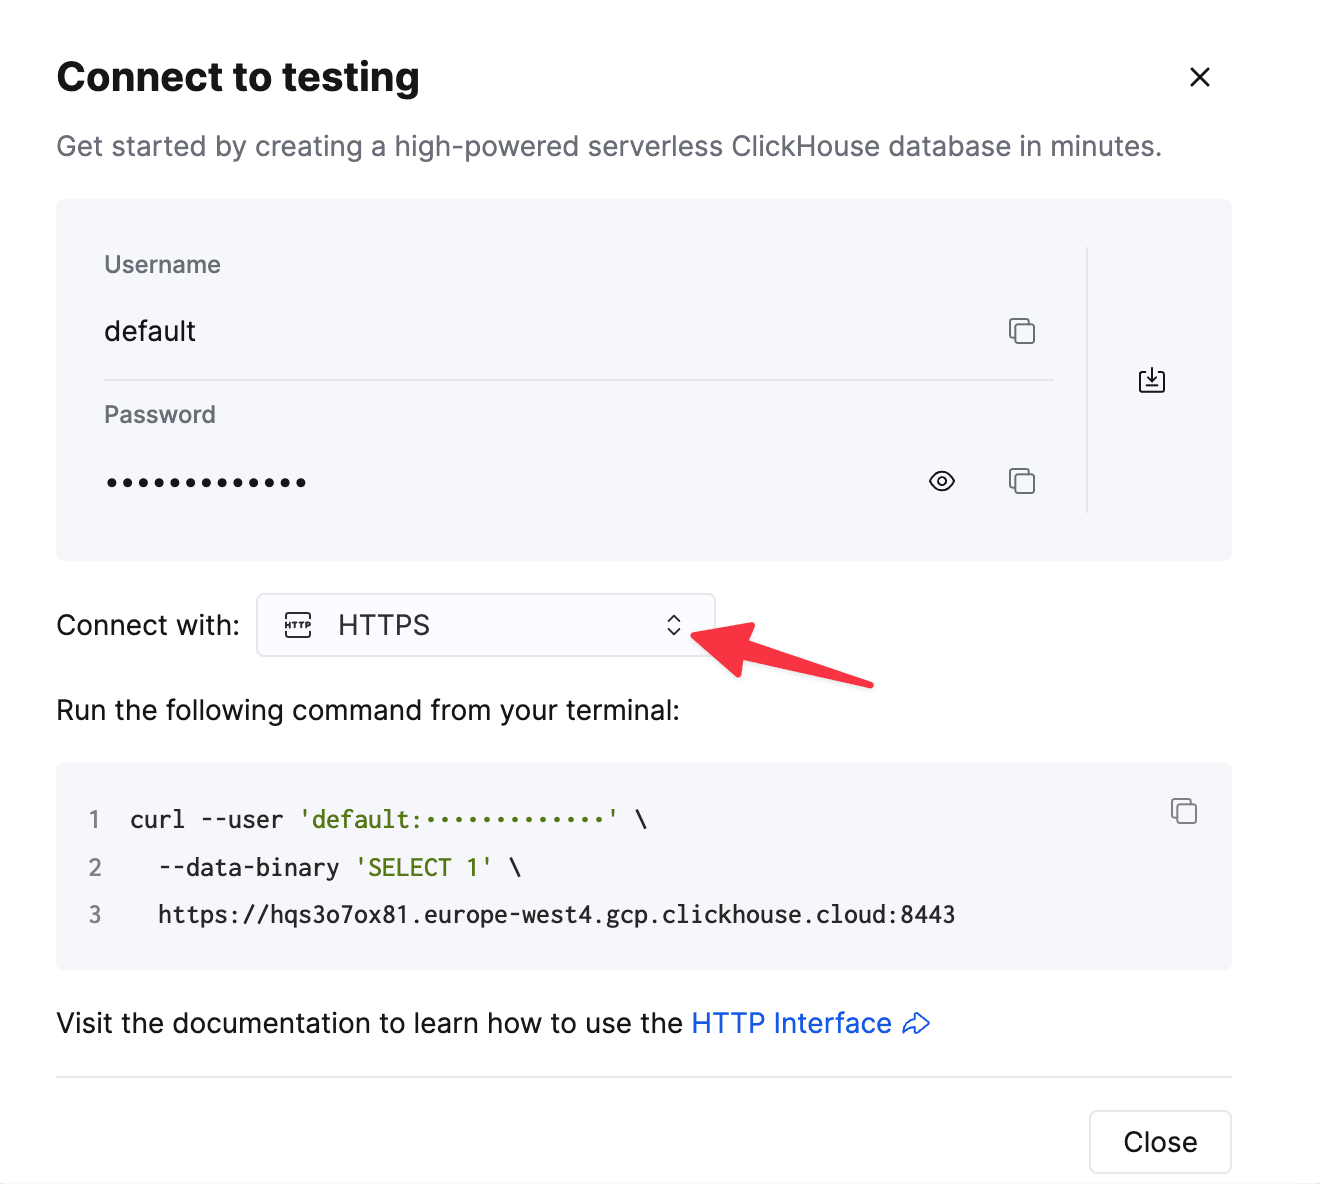
要通过 HTTP(S) 连接到 ClickHouse,你需要以下信息:
| Parameter(s) | Description |
|---|---|
HOST and PORT |
通常,使用 TLS 时端口为 8443;不使用 TLS 时端口为 8123。 |
DATABASE NAME |
默认情况下,存在一个名为 default 的数据库。请使用你要连接的数据库名称。 |
USERNAME and PASSWORD |
默认情况下,用户名为 default。请根据你的使用场景使用相应的用户名。 |
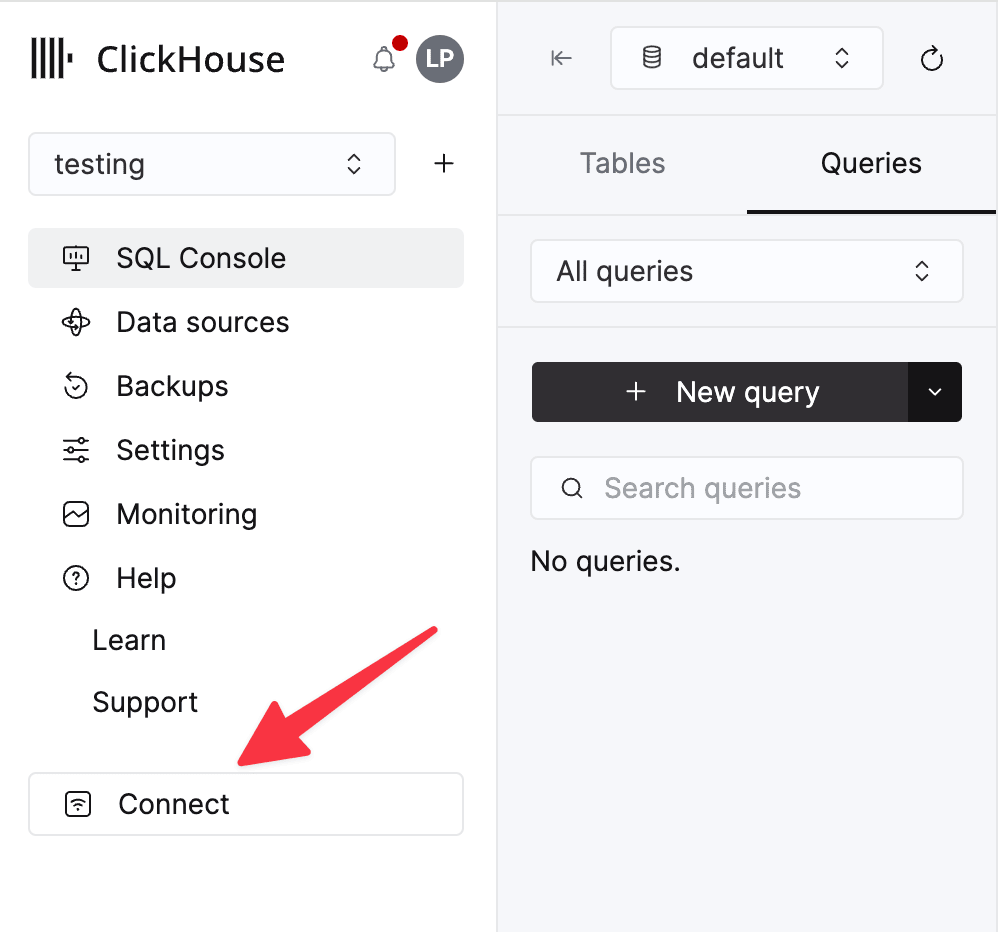
你的 ClickHouse Cloud 服务的连接信息可在 ClickHouse Cloud 控制台中查看。 选择一个服务,然后点击 Connect:
选择 HTTPS。连接信息会显示在示例 curl 命令中。
如果你使用的是自管理 ClickHouse,则连接信息由你的 ClickHouse 管理员配置。
安装 Kafka Connect 和连接器
我们假设你已经下载了 Confluent 软件包并已在本地完成安装。请按照此处文档中的说明安装连接器。
如果你使用 confluent-hub 安装方式,本地配置文件将会被更新。
为了将数据从 Kafka 发送到 ClickHouse,我们使用该连接器的 Sink 组件。
准备配置
请按照这些说明设置与你的安装类型对应的 Connect,并注意 standalone 和分布式集群之间的差异。如果使用 Confluent Cloud,则应采用分布式部署。
以下参数与将 JDBC 连接器 搭配 ClickHouse 使用相关。完整参数列表可在此处查看:
_connection.url_- 应采用jdbc:clickhouse://<clickhouse host>:<clickhouse http port>/<target database>的形式connection.user- 对目标数据库具有写入权限的用户table.name.format- 要插入数据的 ClickHouse 表。该表必须已存在。batch.size- 单个批次发送的行数。请确保该值设置得足够大。根据 ClickHouse 的建议,1000 应视为最小值。tasks.max- JDBC Sink 连接器 支持运行一个或多个任务。这可以用来提升性能。结合批次大小,这是提升性能的主要方式。value.converter.schemas.enable- 如果使用 Schema Registry,则设为 false;如果将 schema 嵌入消息中,则设为 true。value.converter- 根据你的数据类型进行设置,例如对于 JSON,设为io.confluent.connect.json.JsonSchemaConverter。key.converter- 设为org.apache.kafka.connect.storage.StringConverter。我们使用 String 类型的 key。pk.mode- 与 ClickHouse 无关。设为 none。auto.create- 不受支持,必须设为 false。auto.evolve- 我们建议将此项设为 false,尽管未来可能会支持。insert.mode- 设为 "insert"。当前不支持其他模式。key.converter- 根据你的 key 类型进行设置。value.converter- 根据 topic 中的数据类型进行设置。该数据必须具有受支持的 schema,即 JSON、Avro 或 Protobuf 格式。
如果使用我们的样本数据集进行测试,请确保设置以下内容:
value.converter.schemas.enable- 设为 false,因为我们使用 Schema Registry。如果你将 schema 嵌入每条消息中,则设为 true。key.converter- 设为 "org.apache.kafka.connect.storage.StringConverter"。我们使用 String 类型的 key。value.converter- 设为 "io.confluent.connect.json.JsonSchemaConverter"。value.converter.schema.registry.url- 设置 schema server 的 URL,并通过参数value.converter.schema.registry.basic.auth.user.info提供 schema server 的凭据。
GitHub 样本数据的配置文件示例可在此处找到,前提是 Connect 以 standalone 模式运行,且 Kafka 托管在 Confluent Cloud 中。
创建 ClickHouse 表
请确保该表已创建;如果它因前面的示例已存在,请先将其删除。下面展示了一个与精简版 GitHub 数据集兼容的示例。请注意,其中不包含任何当前尚不受支持的 Array 或 Map 类型:
CREATE TABLE github
(
    file_time DateTime,
    event_type Enum('CommitCommentEvent' = 1, 'CreateEvent' = 2, 'DeleteEvent' = 3, 'ForkEvent' = 4, 'GollumEvent' = 5, 'IssueCommentEvent' = 6, 'IssuesEvent' = 7, 'MemberEvent' = 8, 'PublicEvent' = 9, 'PullRequestEvent' = 10, 'PullRequestReviewCommentEvent' = 11, 'PushEvent' = 12, 'ReleaseEvent' = 13, 'SponsorshipEvent' = 14, 'WatchEvent' = 15, 'GistEvent' = 16, 'FollowEvent' = 17, 'DownloadEvent' = 18, 'PullRequestReviewEvent' = 19, 'ForkApplyEvent' = 20, 'Event' = 21, 'TeamAddEvent' = 22),
    actor_login LowCardinality(String),
    repo_name LowCardinality(String),
    created_at DateTime,
    updated_at DateTime,
    action Enum('none' = 0, 'created' = 1, 'added' = 2, 'edited' = 3, 'deleted' = 4, 'opened' = 5, 'closed' = 6, 'reopened' = 7, 'assigned' = 8, 'unassigned' = 9, 'labeled' = 10, 'unlabeled' = 11, 'review_requested' = 12, 'review_request_removed' = 13, 'synchronize' = 14, 'started' = 15, 'published' = 16, 'update' = 17, 'create' = 18, 'fork' = 19, 'merged' = 20),
    comment_id UInt64,
    path String,
    ref LowCardinality(String),
    ref_type Enum('none' = 0, 'branch' = 1, 'tag' = 2, 'repository' = 3, 'unknown' = 4),
    creator_user_login LowCardinality(String),
    number UInt32,
    title String,
    state Enum('none' = 0, 'open' = 1, 'closed' = 2),
    assignee LowCardinality(String),
    closed_at DateTime,
    merged_at DateTime,
    merge_commit_sha String,
    merged_by LowCardinality(String),
    review_comments UInt32,
    member_login LowCardinality(String)
) ENGINE = MergeTree ORDER BY (event_type, repo_name, created_at)
启动 Kafka Connect
以 standalone 或 distributed 模式启动 Kafka Connect。
./bin/connect-standalone connect.properties.ini github-jdbc-sink.properties.ini将数据添加到 Kafka
使用提供的脚本和配置向 Kafka 写入消息。你需要修改 github.config,加入你的 Kafka 凭据。该脚本当前已配置为与 Confluent Cloud 配合使用。
python producer.py -c github.config此脚本可用于将任何 ndjson 文件插入到 Kafka topic 中。它会尝试自动为你推断 schema。提供的示例 config 只会插入 10k 条消息——如有需要,请在此修改。此 configuration 在插入到 Kafka 时还会从数据集中移除所有不兼容的 Array 字段。
这是 JDBC 连接器 将消息转换为 INSERT 语句所必需的。如果你使用自己的数据,请确保要么在每条消息中都插入 schema (将 _value.converter.schemas.enable _设为 true) ,要么确保你的 client 发布的消息引用了 registry 中的 schema。
Kafka Connect 应该会开始消费消息并将行插入到 ClickHouse 中。请注意,关于 "[JDBC Compliant Mode] Transaction isn't supported." 的警告是预期行为,可以忽略。
对目标表 "Github" 执行一个简单的查询应能确认数据已插入。
SELECT count() FROM default.github;| count\(\) |
| :--- |
| 10000 |